Позначка: технології

  • ШІ під забороною: як заяви про ризики обернулися проблемами для одного з лідерів галузі

    ШІ під забороною: як заяви про ризики обернулися проблемами для одного з лідерів галузі

    Одна з найвідоміших компаній у сфері штучного інтелекту Anthropic опинилася в центрі масштабної дискусії щодо майбутнього регулювання ШІ-технологій. Як з’ясувало видання Financial Times, у своїх публічних комунікаціях компанія значно частіше за конкурентів наголошувала на ризиках, загрозах та необхідності державного контролю над штучним інтелектом. Частина представників технологічної індустрії вважає, що саме така стратегія могла вплинути на рішення влади США обмежити використання найновіших моделей Anthropic за межами країни.

    За даними Financial Times, у 2026 році Anthropic використовувала терміни, пов’язані з ризиками, небезпеками, обмеженнями та регулюванням штучного інтелекту приблизно у вісім разів частіше, ніж OpenAI. Видання проаналізувало офіційні заяви компаній, блоги, інтерв’ю керівників, публікації в соціальних мережах та інші відкриті матеріали.

    Результати дослідження показали помітну різницю у підходах до комунікації. Якщо в матеріалах Anthropic на кожну тисячу слів припадало близько п’яти згадок про ризики, регулювання або обмеження, то в OpenAI цей показник становив лише 0,6 згадки.

    Для аналізу журналісти використали спеціальний перелік ключових слів, серед яких були терміни «ризик», «небезпечний», «вразливість», «шкідливий», «запобіжник» та інші подібні формулювання.

    Зокрема, лише слово «ризик» у публічних матеріалах Anthropic за 2026 рік згадувалося 336 разів. Для порівняння, в OpenAI цей показник становив лише 30 згадок. Термін «запобіжник» компанія Даріо Амодеї використала 121 раз, тоді як OpenAI – 33 рази. Слово «вразливість» з’являлося у комунікаціях Anthropic 128 разів проти лише десяти випадків у конкурентів.

    Після того як Міністерство торгівлі США запровадило експортні обмеження щодо новітніх моделей Anthropic – Mythos і Fable – частина експертів почала відкрито звинувачувати компанію у тому, що вона сама сприяла появі таких заборон.

    Найгучніше висловився один із піонерів сучасного штучного інтелекту, головний науковий співробітник Meta Ян ЛеКун. Він розкритикував керівництво Anthropic за надмірне наголошення на потенційних загрозах технології та назвав таку риторику «нагнітанням страхів».

    На його думку, саме постійні заяви про небезпеку надпотужного ШІ могли вплинути на рішення американських регуляторів обмежити поширення моделей компанії за кордоном.

    До критиків такого підходу раніше приєднувався і глава OpenAI Сем Альтман. Під час одного з подкастів він іронічно коментував заяви про надзвичайну небезпечність нових моделей штучного інтелекту.

    За словами Альтмана, повідомлення в стилі «ми створили бомбу і зараз скинемо її вам на голову» можуть бути ефективним маркетинговим інструментом, однак не завжди допомагають формувати збалансоване бачення технології.

    Anthropic, своєю чергою, давно будує власну репутацію саме навколо безпеки штучного інтелекту. Компанія була заснована колишніми співробітниками OpenAI та з перших днів роботи наголошувала на необхідності відповідального розвитку ШІ.

    Генеральний директор компанії Даріо Амодеї регулярно виступає із закликами до більш активного державного контролю над галуззю. Anthropic також систематично публікує дослідження про потенційні ризики надпотужних моделей та можливі наслідки їхнього використання.

    За кілька днів до введення експортних обмежень Амодеї оприлюднив великий блог, у якому критикував повільну реакцію регуляторів на стрімкий розвиток штучного інтелекту.

    У своєму матеріалі він зазначив, що останні місяці продемонстрували як величезний потенціал нових моделей, так і їхню здатність створювати реальні загрози для кібербезпеки, фінансової системи, критичної інфраструктури та національної безпеки.

    Особливу увагу він приділив моделі Mythos, яку компанія позиціонує як один із найпотужніших інструментів для виявлення критичних кіберзагроз і складних вразливостей у програмному забезпеченні.

    Саме Mythos разом із моделлю Fable опинилися під дією нових американських обмежень.

    Наприкінці минулого тижня Міністерство торгівлі США заборонило доступ до цих систем для іноземних громадян. Рішення викликало значний резонанс у технологічній спільноті та стало предметом активних дискусій щодо майбутньої політики Вашингтона у сфері штучного інтелекту.

    Особливість ситуації полягає в тому, що спочатку сама Anthropic добровільно обмежувала доступ до Mythos через потенційні ризики використання моделі. Компанія співпрацювала з державними структурами США та тестувала систему в обмеженому режимі для окремих організацій.

    Лише на початку червня доступ було частково розширено, однак невдовзі уряд США запровадив уже офіційні експортні обмеження.

    Аналітична платформа AlphaSense назвала Mythos однією з найбільш обговорюваних моделей штучного інтелекту у світі цього року. Пік інтересу до неї спостерігався після презентації у квітні та вдруге – після оголошення про заборону експорту.

    Ситуацію додатково ускладнює те, що відносини між Anthropic та американською владою залишаються напруженими вже кілька місяців. Раніше між сторонами виникали суперечки щодо використання ШІ у сфері державного спостереження та автономних бойових систем.

    У лютому Пентагон навіть включив компанію до переліку ризиків для національної безпеки в окремих ланцюгах постачання. Наразі Anthropic оскаржує це рішення у судовому порядку.

    Попри критику, компанія продовжує наполягати, що питання безпеки повинні залишатися головним пріоритетом у розвитку штучного інтелекту. Водночас історія з Mythos і Fable демонструє, наскільки складним стає баланс між інноваціями, безпекою та державним регулюванням у нову епоху розвитку ШІ.
  • Google запускає музей, у якому картини генерує ШІ

    Google запускає музей, у якому картини генерує ШІ

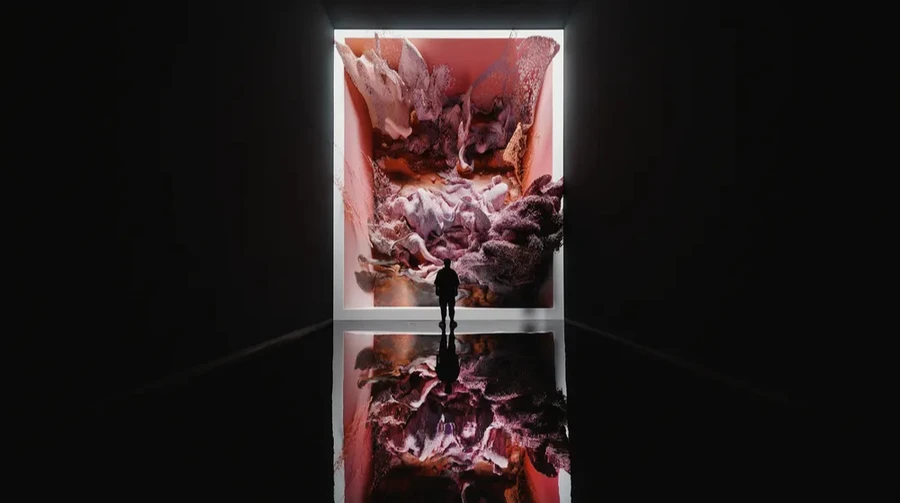
    Google оголосила про запуск масштабного культурно-технологічного проєкту Dataland, який позиціонується як перший у світі музей мистецтва, повністю присвячений штучному інтелекту. Відкриття заплановане на 20 червня в Лос-Анджелесі, і, за задумом розробників, новий простір має стати не просто виставковою залою, а експериментальною платформою, де мистецтво створюється, змінюється та “оживає” у режимі реального часу завдяки алгоритмам машинного навчання.

    Проєкт Dataland розміщений у будівлі The Grand LA, яку спроєктував всесвітньо відомий архітектор Френк Гері, і займає площу приблизно 2,3 тисячі квадратних метрів. Архітектура простору відіграє важливу роль у концепції музею, оскільки він задуманий як повністю інтерактивне середовище, де технології та фізичний простір зливаються в єдину систему сприйняття. Ініціатива реалізується у співпраці Google з медіахудожником Рефіком Анадолом, який відомий своїми роботами на перетині штучного інтелекту, нейромереж та цифрового мистецтва.

    Центральною частиною відкриття стане виставка під назвою “Machine Dreams: Rainforest”, яка демонструватиме зображення, створені штучним інтелектом у режимі реального часу. Система генерує візуальні сцени з надзвичайно високою деталізацією, що, за заявами організаторів, досягає роздільної здатності до 1,2 мільярда пікселів. Ці цифрові “ландшафти” не є статичними творами, а постійно змінюються, реагуючи на алгоритмічні процеси та зовнішні фактори, що робить кожен візит відвідувача унікальним досвідом.

    Окрім візуальної складової, музей використовує складну багаторівневу систему взаємодії з аудиторією. Простір оснащений сенсорами, які аналізують рухи, присутність та реакції відвідувачів, формуючи адаптивне середовище, що змінює як звуковий супровід, так і візуальні елементи експозиції. Додатково система здатна генерувати ароматичні композиції, що перетворює музейний простір на повністю сенсорний досвід, де задіяні зір, слух і нюх одночасно.

    У Google пояснюють, що технологічною основою Dataland є моделі Gemini, які працюють на інфраструктурі Google Cloud. Це означає, що створення художнього контенту відбувається не локально, а у глобальних датацентрах компанії, після чого результат у реальному часі транслюється до музейного простору. Така архітектура дозволяє безперервно оновлювати експозицію, фактично перетворюючи музей на живу систему, яка ніколи не повторюється у тому самому вигляді.

    Запуск Dataland відбувається на тлі тривалої дискусії у світовому мистецькому середовищі щодо статусу творів, створених штучним інтелектом. Частина критиків вважає такі роботи інструментальним продуктом алгоритмів, тоді як інші розглядають їх як нову форму креативності, де людина виступає куратором або співтворцем, а не єдиним автором. У Google фактично займають позицію на користь другого підходу, просуваючи ідею ШІ як повноцінного учасника творчого процесу.

    Паралельно з відкриттям музею запускається програма AI Artist Residency, реалізована платформою Google Arts & Culture. Вона передбачає гранти у розмірі 25 тисяч доларів для митців, які працюють із технологіями штучного інтелекту, а також менторську підтримку від студії Refik Anadol Studio і доступ до інструментів машинного навчання Google. Протягом року роботи учасників програми планують демонструвати як у самому Dataland, так і на цифрових платформах компанії.

    Таким чином Dataland фактично поєднує в собі одразу кілька функцій — музей, дослідницьку лабораторію, художню платформу та технологічний демонстраційний центр. Експерти вже називають цей проєкт спробою переосмислити саму концепцію музею як інституції, де замість статичних експонатів існують динамічні цифрові системи, що постійно змінюються під впливом алгоритмів і взаємодії з людьми.

  • Україна під кіберзахистом ЄС: Брюссель відкрив доступ до екстреної допомоги

    Україна під кіберзахистом ЄС: Брюссель відкрив доступ до екстреної допомоги

    Україну офіційно включено до Резерву кібербезпеки Європейського Союзу, що відкриває для держави новий рівень доступу до екстреної технічної допомоги у випадку масштабних кіберінцидентів і фактично інтегрує її у спільну європейську систему швидкого реагування на цифрові загрози. Відповідне рішення ухвалила Рада Європейського Союзу, а про запуск механізму та його розширення на Україну повідомили в Європейській комісії, наголосивши на посиленні стратегічної кіберспівпраці з партнерами, які стикаються з постійним тиском у цифровому просторі.

    Резерв кібербезпеки ЄС є частиною ширшої архітектури цифрової оборони Євросоюзу і функціонує як інструмент оперативного реагування на серйозні або транскордонні кібератаки. Його робота координується Європейським агентством з кібербезпеки ENISA, яке відповідає за залучення перевірених приватних постачальників кіберпослуг, здатних у найкоротші терміни підключатися до інцидентів у державах-членах або країнах-партнерах. Йдеться про експертні команди реагування, які можуть допомагати у локалізації атак, відновленні зламаних систем, аналізі шкідливого програмного забезпечення та посиленні захисту критичної інфраструктури.

    Фактично цей механізм створений для того, щоб у разі масштабної кібератаки жодна країна не залишалася наодинці з кризою цифрової безпеки. Україна, яка вже протягом багатьох років перебуває під постійним кібертиском, зокрема з боку Росії, отримує через це рішення додатковий інструмент швидкого доступу до європейських ресурсів кіберзахисту. У разі потреби держава зможе активувати екстрену підтримку і залучати фахівців ЄС для реагування на інциденти державного масштабу або атаки на критичні системи, включно з енергетикою, зв’язком, державними реєстрами чи фінансовими сервісами.

    У Європейській комісії підкреслюють, що розширення Резерву на Україну є частиною більш широкої стратегії зміцнення цифрової безпеки всього європейського простору та його партнерів. В Брюсселі зазначають, що сучасні кіберзагрози не мають кордонів, а отже відповідь на них також має бути спільною і скоординованою. У цьому контексті Україна розглядається як один із ключових партнерів ЄС у сфері кіберстійкості, який має значний практичний досвід протидії масованим атакам і може одночасно отримувати і передавати експертизу.

    Виконавча віцепрезидентка Європейської комісії з питань технологічного суверенітету, безпеки та демократії Генна Вірккунен заявила, що включення України до Резерву кібербезпеки ЄС є проявом спільної відповідальності та солідарності у цифровій сфері. За її словами, у час, коли кібератаки стали постійним інструментом політичного та військового тиску, особливо важливо формувати єдиний простір реагування, де партнери можуть швидко допомагати одне одному без бюрократичних затримок і технічних бар’єрів.

    Європейський Резерв кібербезпеки вже використовується як інструмент швидкого реагування всередині ЄС, а також поступово розширюється на країни-партнери. Раніше до нього була включена Молдова, яка приєдналася у 2024 році в межах європейського Закону про кіберсолідарність. Розширення на Україну продовжує цю логіку формування спільного цифрового простору безпеки, де критична інфраструктура різних держав захищається за єдиними стандартами і за підтримки спільних ресурсів.

    Для України це рішення має не лише технічне, але й політичне значення, оскільки воно фактично підтверджує поглиблення інтеграції держави у безпекові та цифрові механізми ЄС. Йдеться про поступове наближення до стандартів кіберзахисту Євросоюзу, підвищення стійкості державних систем і створення додаткових гарантій швидкого реагування у кризових ситуаціях. У практичному вимірі це означає, що Україна отримує ще один рівень підтримки у протидії кіберзагрозам, які в умовах сучасної війни часто супроводжують і доповнюють військові дії.

    Таким чином, включення України до Резерву кібербезпеки ЄС можна розглядати як черговий крок у формуванні спільної європейської системи безпеки, де цифровий вимір стає таким же важливим, як і традиційна оборона. Це рішення закріплює роль України як активного учасника європейської кібербезпекової архітектури та підкреслює зростаючу взаємозалежність у сфері захисту від сучасних цифрових загроз.

  • Україна будує свій “цифровий мозок”: як створюють національний ШІ

    Україна будує свій “цифровий мозок”: як створюють національний ШІ

    Півтора року тому Україна зробила стратегічну заявку на входження в глобальну гонку штучного інтелекту не лише як споживач технологій, а як держава, що намагається створити власну фундаментальну AI-інфраструктуру. У центрі цієї амбіції опинилася ідея національної великої мовної моделі — LLM, яка має стати не просто черговим цифровим сервісом, а базовим шаром для державних продуктів, взаємодії громадян із сервісами та навіть елементом аналітичної й безпекової екосистеми країни.

    Ініціатором проєкту виступило Міністерство цифрової трансформації, яке на тлі стрімкого розвитку глобальних моделей на кшталт GPT чи Gemini фактично поставило питання суверенності даних і технологій. Логіка проєкту проста: якщо штучний інтелект дедалі більше впливає на економіку, управління, оборону та освіту, то країна, яка не має власної моделі або контролю над нею, опиняється в технологічній залежності. Саме тому в Україні було ухвалено рішення розпочати створення власної LLM, що отримала назву «Сяйво».

    Початкові очікування були доволі оптимістичними. Уряд розраховував, що перші результати можна буде показати вже наприкінці 2025 року, а навесні 2026 року модель стане доступною для публічного тестування. Однак у міру занурення в технічну реалізацію стало очевидно, що проєкт значно складніший, ніж виглядав на рівні концепції. Строки почали зсуватися, а сама архітектура проєкту — змінюватися.

    Важливу роль у реалізації відіграло партнерство Мінцифри з компанією «Київстар», яке було оформлене у вигляді державно-приватної моделі. Саме оператор мобільного зв’язку взяв на себе фінансування, формування технічної команди та частину інженерної розробки, тоді як держава відповідала за координацію, доступ до даних і формування етичних та правових рамок. Такий підхід мав пришвидшити запуск, однак на практиці виявився складнішим через високу складність самої технології.

    Однією з перших серйозних проблем стала робота з даними. Для навчання великої мовної моделі потрібні величезні масиви текстів, і хоча Україна має значний інформаційний ресурс у вигляді архівів, медіа, наукових робіт і державних документів, значна частина цих матеріалів або юридично захищена, або фізично не оцифрована. Це створило додатковий пласт роботи, який не був повністю врахований на старті. Паралельно виникла необхідність створити систему анонімізації, очищення даних і юридичної перевірки, щоб уникнути порушення авторських прав і захистити персональну інформацію.

    Ще одним викликом став кадровий дефіцит. Фахівців із досвідом саме у тренуванні великих мовних моделей в Україні небагато, а глобальний ринок таких спеціалістів є надзвичайно конкурентним. Частину команди довелося формувати з інженерів суміжних напрямів, яких додатково навчали специфіці LLM-розробки. Формування повноцінної команди розтягнулося на місяці, а паралельно до роботи залучалися зовнішні експерти та консультанти.

    Технічна складність проєкту також виявилася вищою за очікування. Українська LLM будується не на класичних для індустрії Nvidia GPU, а на інфраструктурі Google TPU, що вимагало адаптації інструментів і підходів до тренування. Це означало не лише інший стек технологій, а й необхідність перебудови частини пайплайнів навчання моделей.

    Наразі проєкт перебуває на етапі завершення роботи над першою, малою моделлю з приблизно чотирма мільярдами параметрів. Вона не призначена для масового використання, а виконує роль технічного полігону, на якому відпрацьовуються всі ключові процеси: від підготовки даних до оцінки якості відповідей та поведінки системи в складних сценаріях. Саме на цьому етапі команда тестує так званий alignment — налаштування моделі так, щоб вона коректно реагувала на чутливі, складні або потенційно небезпечні запити, не виходячи за межі безпечної поведінки.

    За словами учасників проєкту, ця фаза є критично важливою, оскільки дозволяє уникнути дорогих помилок на наступному етапі, коли йтиметься про значно більшу модель. Малу версію планують завершити як технічний етап у другій половині року, після чого команда перейде до створення повноцінної великої LLM, яка вже буде орієнтована на практичне використання.

    Концепція великої моделі також зазнала змін. Якщо спочатку передбачалося поетапне створення трьох рівнів — малої, середньої та великої моделей, то тепер команда вирішила пропустити проміжну стадію і рухатися безпосередньо до масштабної системи. Базою для неї має стати сучасна модель Google Gemma 4, яка значно перевершує попередні версії за показниками логічного мислення, математичних задач і здатності працювати з довгими контекстами.

    Втім, перехід на нову архітектуру додав складності. Уже створений український токенайзер, який оптимізував роботу з українською мовою, тепер потрібно адаптувати до нової моделі. Це фактично означає повторну частину роботи, але з урахуванням уже отриманого досвіду.

    Окремий акцент у проєкті зроблено на українській мові як такій. Сьогодні більшість глобальних моделей опрацьовують українські запити через англомовний «проміжний шар», коли текст спочатку фактично перекладається, а вже потім обробляється. Це призводить до втрати нюансів, стилістики та частини змісту. Щоб уникнути цього, команда формує спеціалізовані українськомовні корпуси даних обсягом у десятки терабайтів і створює механізми, які дозволяють моделі працювати з мовою напряму, без перекладацького посередника.

    Паралельно вибудовується і правова архітектура проєкту. Україна залучає десятки державних і недержавних інституцій до формування датасетів, включаючи медіа, університети, видавництва та архіви. При цьому застосовуються механізми очищення даних від персональної інформації та чутливих відомостей, а також формується система національних бенчмарків, яка має оцінювати не лише точність, а й етичність роботи моделі.

    На рівні інфраструктури держава паралельно будує власну AI-систему, яка має забезпечити автономність у тренуванні та використанні моделей. Йдеться про проєкт AI Factory, який передбачає створення GPU-вузлів, систем охолодження та сховищ даних для роботи зі складними обчисленнями. Частину обладнання вже закуплено, а в перспективі інфраструктура має розширитися до десятків обчислювальних кластерів.

    Попри всі складнощі, у проєкті зберігається оновлений графік. Очікується, що велика українська LLM може бути готова до тестування приблизно наприкінці 2026 року. Після цього її планують передати державі, а згодом розгорнути всередині країни, перенісши з хмарних сервісів на національну інфраструктуру.

    Фактично Україна намагається одночасно вирішити три завдання: наздогнати глобальний розвиток штучного інтелекту, створити власну мовну модель і закласти основу для цифрового суверенітету. Це складний і довготривалий процес, у якому технологічні виклики переплітаються з юридичними, кадровими та інституційними. Але саме від того, наскільки успішно він буде реалізований, залежить, чи стане Україна не лише користувачем глобальних AI-систем, а й їхнім повноцінним розробником.

  • Міністра цифровізації Німеччини запідозрили у використанні ШІ

    Міністра цифровізації Німеччини запідозрили у використанні ШІ

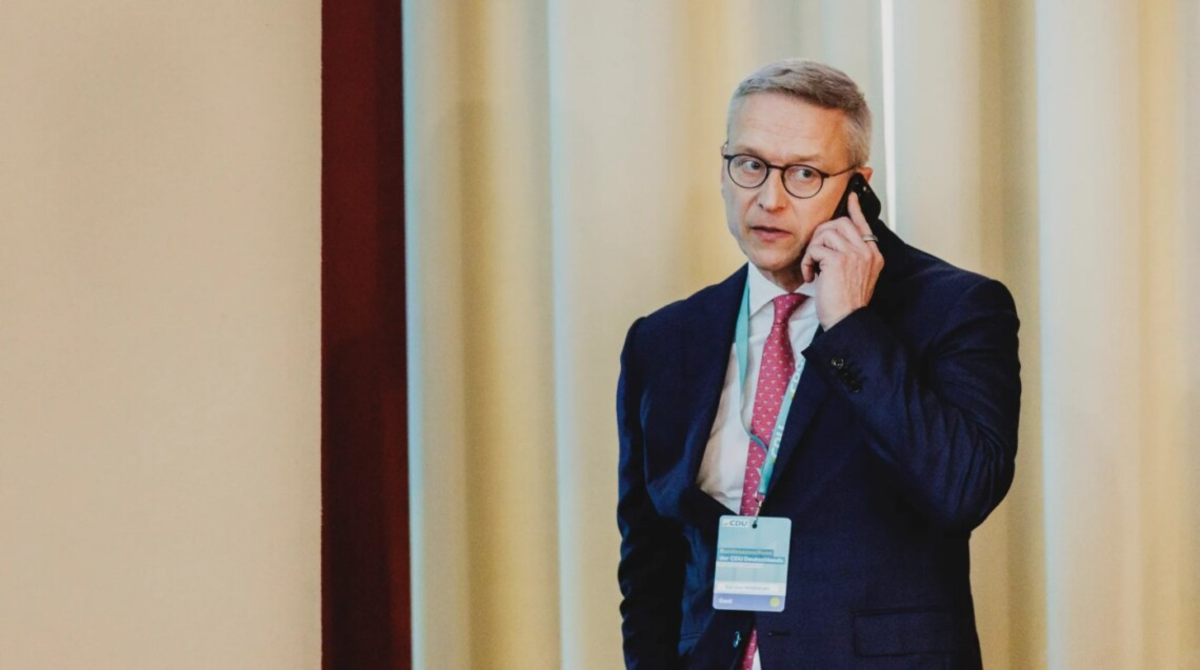
    У Німеччині розгорівся резонансний політичний та медійний скандал навколо міністра цифрових технологій Карстена Вільдбергера, якого запідозрили у системному використанні штучного інтелекту під час підготовки офіційних текстів, промов та публічних заяв. Про це повідомляє агенція dpa, посилаючись на урядові джерела та матеріали журналістських розслідувань.

    Суперечка вибухнула на тлі активного просування Німеччиною політики цифрової трансформації державного сектору, яка передбачає ширше впровадження технологій штучного інтелекту в роботу міністерств, адміністрацій і судової системи. Міністерство цифрових технологій, створене у 2025 році, було одним із ключових інструментів модернізації державного управління, однак саме його очільник тепер опинився в центрі дискусії про межі допустимого використання ШІ на найвищому рівні влади.

    Перші підозри щодо використання алгоритмів виникли після публікації низки виступів і статей, авторство яких приписується Вільдбергеру. Журналісти видання Die Zeit провели аналіз текстів із застосуванням спеціалізованого програмного забезпечення, призначеного для виявлення контенту, згенерованого штучним інтелектом. За їхніми висновками, у матеріалах містяться ознаки машинної генерації, зокрема характерні стилістичні повтори, узагальнені конструкції та структура, притаманна текстам, створеним нейромережами.

    У центрі уваги опинилися не лише публікації в німецьких медіа, а й парламентські промови, а також виступи міністра на міжнародних майданчиках. Зокрема, згадується його промова у 2024 році в аналітичному центрі Атлантичної ради у Вашингтоні, яку деякі експерти назвали такою, що могла бути повністю або частково створена за допомогою штучного інтелекту. Окремі аналітики звернули увагу на нетипову для політичної риторики однорідність формулювань і відсутність індивідуального стилю автора.

    Водночас експерти, залучені до перевірки матеріалів, наголошують, що інструменти для визначення використання ШІ не є абсолютно точними. Вони можуть помилково класифікувати людський текст як згенерований алгоритмами, особливо якщо він редагувався або проходив через кілька етапів автоматичної обробки. Це стало одним із ключових аргументів захисників міністра, які закликають утриматися від передчасних висновків.

    Офіційна позиція міністерства цифрових технологій полягає в тому, що Карстен Вільдбергер справді використовує штучний інтелект у своїй роботі, однак виключно як допоміжний інструмент. Речник відомства заявив, що мова йде про «робочого асистента», який допомагає структурувати думки, редагувати тексти, скорочувати довгі формулювання та пропонувати альтернативні варіанти викладу.

    У міністерстві підкреслюють, що така практика є частиною загальноєвропейського тренду цифровізації державного управління. Там вважають, що державні службовці мають не уникати штучного інтелекту, а навпаки — навчитися ефективно його використовувати. Водночас наголошується, що кожен документ, промова або офіційна заява проходить обов’язкову людську перевірку та затвердження перед публікацією.

    «Штучний інтелект можна розглядати як інструмент для роботи з інформацією — подібно до текстових редакторів чи аналітичних систем. Він допомагає пришвидшити процес підготовки матеріалів, але не замінює політичну відповідальність людини», — зазначили у відомстві.

    Попри це, критики ситуації наголошують, що використання ШІ високопосадовцями може створювати ризики розмивання персональної відповідальності за політичні заяви. Деякі експерти також звертають увагу на можливі проблеми прозорості: громадськість не завжди може відрізнити, де закінчується особиста позиція політика і починається машинна генерація тексту.

    Скандал швидко вийшов за межі суто технічної дискусії і переріс у ширшу політичну дебату про майбутнє штучного інтелекту в державному управлінні. У німецькому суспільстві та медіа почали обговорювати питання, чи повинні політики офіційно декларувати використання ШІ при підготовці своїх виступів і документів, а також чи потрібні нові правові норми для регулювання таких практик.

    На тлі скандалу в Бундестазі вже лунають заклики розробити чіткі правила використання штучного інтелекту в урядових структурах, включно з вимогами до прозорості, фіксації участі ШІ у створенні документів та визначенням меж його застосування.

    Аналітики відзначають, що ця ситуація може стати одним із перших гучних прецедентів у Європі, коли питання використання штучного інтелекту в політиці виходить на рівень загальнонаціональної дискусії і потенційних законодавчих змін.

  • Інсайдерська схема на $2,6 млн: обшуки в Samsung шокували технологічний ринок

    Інсайдерська схема на $2,6 млн: обшуки в Samsung шокували технологічний ринок

    Одна з найбільших технологічних компаній світу опинилася в центрі масштабного розслідування. Прокуратура Південної Кореї провела обшуки в офісах Samsung Electronics у межах справи про можливу інсайдерську торгівлю, пов’язану з придбанням робототехнічної компанії Rainbow Robotics. Слідчі перевіряють інформацію про те, що керівники та співробітники компанії могли заробити мільйони доларів, використовуючи закриті дані про майбутню угоду із Samsung.

    Про це повідомляють південнокорейські ЗМІ та профільні технологічні видання з посиланням на прокуратуру Південного округу Сеула.

    Розслідування стосується подій, які передували повному поглинанню Rainbow Robotics компанією Samsung Electronics. Правоохоронці підозрюють, що окремі посадовці могли заздалегідь знати про майбутню угоду та використати цю інформацію для купівлі акцій або проведення фінансових операцій, які принесли їм значний прибуток після зростання вартості компанії.

    За попередніми даними, під підозрою перебувають 16 осіб. Серед них називають генерального директора Rainbow Robotics та фінансового директора компанії. За версією слідства, у період із 2022 по 2024 рік вони могли отримати незаконний дохід у розмірі від 3 до 4 мільярдів південнокорейських вон, що еквівалентно приблизно 1,9–2,6 мільйона доларів США.

    Слідчі вважають, що посадовці могли скористатися конфіденційною інформацією про плани Samsung щодо розширення присутності на ринку робототехніки та майбутнє придбання Rainbow Robotics. Якщо ці підозри підтвердяться, йтиметься про порушення Закону Південної Кореї про ринок капіталу та фінансові інвестиції.

    Під час обшуків правоохоронці вилучили документи, електронні носії інформації та внутрішню корпоративну переписку. Наразі триває аналіз отриманих матеріалів.

    Історія Rainbow Robotics привертає особливу увагу через її значення для майбутньої стратегії Samsung. Компанію було засновано дослідниками Корейського інституту передових технологій (KAIST), які брали участь у створенні першого корейського людиноподібного робота HUBO. З моменту заснування Rainbow Robotics стала одним із найперспективніших виробників роботизованих систем у країні.

    Компанія спеціалізується на створенні широкого спектра роботів: від колаборативних роботів для промисловості до сервісних систем, які можуть працювати в ресторанах, кафе та готелях. Окремий напрямок діяльності — розробка чотириногих роботів і гуманоїдних платформ для оборонного сектору, патрулювання та роботи в небезпечних умовах.

    Samsung почала активно інвестувати в Rainbow Robotics ще у 2023 році. Тоді технологічний гігант придбав значний пакет акцій компанії, а згодом поступово збільшував свою частку. У 2025 році Samsung остаточно отримала контроль над Rainbow Robotics, зробивши її своєю дочірньою структурою.

    Аналітики називають це придбання одним із найважливіших кроків Samsung на шляху до нової технологічної революції. Якщо протягом останніх десятиліть компанія асоціювалася переважно зі смартфонами, побутовою технікою та напівпровідниками, то тепер вона активно готується до епохи роботизації та штучного інтелекту.

    Особливий інтерес викликає проєкт гуманоїдного робота RB-Y1, який Rainbow Robotics представила останніми роками. Машина здатна пересуватися на колесах, виконувати складні маніпуляції руками та взаємодіяти з навколишнім середовищем за допомогою систем штучного інтелекту.

    Раніше Samsung вже заявляла про намір масштабно інтегрувати роботів і агентний штучний інтелект у власне виробництво до 2030 року. Компанія розраховує створити так звані «розумні фабрики майбутнього», де значна частина виробничих процесів буде автоматизована за допомогою робототехнічних комплексів нового покоління.

    Саме тому нинішній скандал привернув величезну увагу інвесторів. Будь-які розслідування, пов’язані з інсайдерською торгівлею, можуть впливати на довіру ринку та викликати додаткові питання до корпоративного управління компаній.

    Водночас експерти наголошують, що наразі підозри стосуються окремих посадовців Rainbow Robotics, а не самої Samsung Electronics як корпорації. Представники компанії поки не коментували деталі розслідування, заявивши лише про готовність співпрацювати зі слідством.

    Для світового ринку робототехніки ця історія має особливе значення. За прогнозами міжнародних консалтингових агентств, обсяг ринку роботів та автоматизованих систем до кінця десятиліття може перевищити сотні мільярдів доларів. Провідні технологічні компанії — від Tesla та Nvidia до Samsung і Hyundai — вже ведуть боротьбу за лідерство в новій галузі.

    На цьому тлі Rainbow Robotics розглядається як один із найцінніших активів азійського ринку робототехніки. Саме тому будь-які події навколо компанії миттєво привертають увагу інвесторів та світових медіа.

    Наразі розслідування триває. Якщо підозри прокуратури підтвердяться, фігурантам може загрожувати не лише багатомільйонний штраф, а й кримінальна відповідальність. Водночас справа може стати одним із найбільших корпоративних скандалів у технологічній галузі Південної Кореї за останні роки.

    Поки слідчі аналізують вилучені матеріали, ринок уважно стежить за розвитком подій. Адже на кону — не лише репутація окремих менеджерів, а й майбутнє одного з найамбітніших робототехнічних проєктів сучасності.

  • Путін у паніці відключав власні камери: штучний інтелект відкрив несподівану «дірку» в безпеці Кремля

    Путін у паніці відключав власні камери: штучний інтелект відкрив несподівану «дірку» в безпеці Кремля

    Російські спецслужби були змушені тимчасово відключити частину спеціальної системи відеоспостереження, яка використовується для охорони Володимира Путіна та найближчого оточення. Причиною стала нова загроза, яка налякала Кремль більше, ніж традиційні кібератаки чи диверсійні операції. Йдеться про стрімкий розвиток штучного інтелекту, здатного перетворювати звичайні камери спостереження на потужний інструмент розвідки. Про це повідомляє Financial Times із посиланням на джерела, обізнані з ситуацією.

    За даними видання, тривогу в Москві викликала нещодавня операція проти вищого керівництва Ірану, під час якої ізраїльська розвідка використала масиви відеоданих із дорожніх камер Тегерана для відстеження пересувань високопоставлених чиновників. Саме після цього російські силовики почали термінову перевірку власних систем безпеки.

    Financial Times стверджує, що російські спецслужби навіть тимчасово зупинили роботу окремої спеціальної системи відеоспостереження, яка не пов’язана із загальноміською мережею камер Москви. Повернути її до роботи дозволили лише після додаткового аудиту та спроб максимально ізолювати систему від зовнішніх мереж і потенційного несанкціонованого доступу.

    Особливий страх у Кремлі викликав саме спосіб проведення операції проти іранського керівництва. За інформацією FT, ізраїльські спецслужби роками збирали інформацію з міської мережі камер Тегерана. Отримані дані дозволили створити так званий «патерн життя» — детальну карту переміщень, звичок, маршрутів охорони та контактів високопосадовців. У результаті розвідка змогла визначити точний час і місце проведення закритої наради за участю верхівки іранського режиму.

    Фахівці пояснюють, що сучасні алгоритми штучного інтелекту кардинально змінили можливості аналізу відеоінформації. Якщо раніше співробітникам спецслужб доводилося вручну переглядати години записів або використовувати обмежені системи розпізнавання облич, то нині алгоритми можуть аналізувати мільйони годин відео практично в реальному часі.

    Ба більше, нові технології здатні знаходити не лише конкретних людей або автомобілі. ШІ навчився визначати моделі поведінки. Наприклад, алгоритм може виявити людину, яка регулярно змінює зовнішність, користується різними транспортними засобами або часто з’являється поруч із певними об’єктами. Саме такі поведінкові закономірності дозволяють спецслужбам встановлювати зв’язки між людьми та прогнозувати їхні подальші дії.

    Financial Times зазначає, що новітні системи вже дозволяють працювати з відео майже так само, як із пошуковими системами. Аналітик може поставити текстовий запит на кшталт: «знайти всіх людей, які передавали пакети в певному районі протягом останнього місяця» або «показати автомобілі, які регулярно супроводжували конкретний кортеж». Раніше виконання подібного завдання могло займати тижні, тепер — лічені хвилини.

    Для Росії ця проблема має особливе значення. Країна створила одну з найбільших систем відеоспостереження у світі. Лише в Москві працюють сотні тисяч камер, багато з яких інтегровані з технологіями розпізнавання облич. Російська влада активно використовувала ці інструменти для контролю протестів, пошуку підозрюваних та стеження за громадянами. Тепер же виявилося, що ця ж система потенційно може стати джерелом інформації для іноземних спецслужб.

    Додатковим фактором занепокоєння стали численні випадки проникнення у російські цифрові системи. Західні медіа та аналітичні центри неодноразово повідомляли про успішні операції українських кіберфахівців та хакерських груп, які отримували доступ до внутрішніх російських ресурсів. На цьому тлі навіть добре захищені мережі відеоспостереження почали розглядатися як потенційна вразливість.

    Експерти вважають, що історія з Кремлем демонструє глобальну зміну правил гри у сфері безпеки. Ще кілька років тому масове відеоспостереження сприймалося як перевага держави над громадянами. Сьогодні ж величезні мережі камер можуть обертатися проти самих урядів, якщо доступ до них отримують професійні розвідки або кібероператори, оснащені сучасними інструментами штучного інтелекту.

    Втім, аналітики наголошують, що навіть найсучасніші системи мають свої обмеження. Технології не гарантують стовідсоткової точності та можуть помилятися через зміну зовнішності, погану якість відео або використання елементарних засобів маскування. Однак швидкість обробки даних та можливість автоматичного аналізу величезних масивів інформації вже зараз роблять штучний інтелект одним із найпотужніших інструментів сучасної розвідки.

    Саме тому історія з тимчасовим відключенням систем охорони Путіна стала показовим сигналом для всіх спецслужб світу. Кремль, який роками будував одну з наймасштабніших систем цифрового контролю, раптом усвідомив, що в епоху штучного інтелекту навіть власні камери можуть стати небезпечними.

  • «Чат мертвий»: OpenAI готує радикальне перезавантаження ChatGPT

    «Чат мертвий»: OpenAI готує радикальне перезавантаження ChatGPT

    Американська технологічна компанія OpenAI готує найбільшу трансформацію ChatGPT з моменту запуску сервісу наприкінці 2022 року. Згідно з інформацією Financial Times, компанія планує радикально змінити концепцію свого найвідомішого продукту, перетворивши його з популярного чат-бота на повноцінну платформу цифрових помічників та агентів штучного інтелекту, які зможуть виконувати реальні завдання від імені користувачів. Цей крок розглядається як ключовий елемент нової стратегії OpenAI, яка прагне забезпечити довгострокове зростання доходів, зміцнити свої позиції на ринку та підготуватися до можливого виходу на фондову біржу.

    За останні кілька років ChatGPT став одним із найвідоміших технологічних продуктів у світі. Після запуску у листопаді 2022 року сервіс буквально змінив ставлення суспільства до штучного інтелекту. Якщо раніше технології ШІ залишалися переважно інструментами для вузького кола фахівців, то ChatGPT зробив їх масовими та доступними для сотень мільйонів людей. Саме OpenAI стала компанією, яка фактично запустила глобальний бум генеративного штучного інтелекту, змусивши технологічних гігантів по всьому світу вкладати мільярди доларів у розвиток аналогічних систем.

    Однак успіх ChatGPT приніс компанії не лише популярність, а й нові виклики. Попри величезну аудиторію, яка, за даними видання, вже наближається до одного мільярда користувачів, OpenAI продовжує витрачати колосальні кошти на розвиток своїх моделей. Навчання сучасних систем штучного інтелекту вимагає величезних обчислювальних потужностей, дорогих графічних процесорів, будівництва центрів обробки даних та постійного вдосконалення інфраструктури. На цьому тлі інвестори дедалі частіше очікують від компанії не лише технологічних проривів, а й чіткої стратегії виходу на стабільну прибутковість.

    Саме тому керівництво OpenAI почало переглядати роль ChatGPT у власній екосистемі. Якщо раніше продукт сприймався як інструмент для спілкування зі штучним інтелектом, то тепер його дедалі більше розглядають як своєрідний вхідний портал до ширшого набору сервісів. Усередині компанії формується бачення ChatGPT як універсального цифрового центру, який поєднуватиме різноманітні інструменти для роботи, навчання, програмування, управління завданнями та автоматизації бізнес-процесів.

    Одним із головних напрямків майбутньої трансформації стане розвиток агентів штучного інтелекту. На відміну від звичайних чат-ботів, які переважно відповідають на запити користувачів, агенти здатні самостійно виконувати складні багатокрокові дії. Вони можуть аналізувати інформацію, ухвалювати проміжні рішення, взаємодіяти з іншими сервісами та завершувати поставлені завдання без постійного контролю людини. Саме цей напрямок у OpenAI дедалі частіше називають наступною великою еволюцією індустрії штучного інтелекту.

    У майбутньому такі системи можуть самостійно бронювати авіаквитки та готелі, координувати зустрічі, вести календарі, створювати презентації, працювати з електронною поштою, проводити аналіз документів, готувати звіти або виконувати складні робочі процеси у корпоративному середовищі. Іншими словами, йдеться про перехід від формату «запитання-відповідь» до формату «поставив завдання — отримав готовий результат».

    Особливе місце у новій стратегії відводиться продукту OpenAI Codex. Компанія має намір суттєво збільшити інвестиції в його розвиток, оскільки програмування вважається одним із найбільш перспективних напрямків застосування штучного інтелекту. В останні роки інструменти генерації коду стали одним із найшвидше зростаючих сегментів ринку ШІ. Великі корпорації дедалі активніше впроваджують такі рішення для автоматизації розробки програмного забезпечення, скорочення витрат та підвищення продуктивності команд.

    Саме тому OpenAI поступово зміщує акценти від універсального чат-бота до систем, які здатні виконувати реальну роботу. Показовою стала заява одного зі старших співробітників компанії, якого цитує Financial Times: «Чат мертвий». Ця фраза стала відображенням настроїв усередині OpenAI, де все більше фахівців переконані, що традиційна модель спілкування з чат-ботом уже досягла своєї природної межі розвитку. Наступний етап полягає в тому, щоб штучний інтелект не просто надавав інформацію, а діяв самостійно та приносив практичну користь.

    Такі зміни відбуваються на тлі дедалі жорсткішої конкуренції в галузі. Одним із головних суперників OpenAI залишається Anthropic, яка активно розвиває власну модель Claude та поступово завойовує дедалі більшу частку корпоративного ринку. Водночас значні ресурси у сферу штучного інтелекту вкладають також Google, Microsoft, Meta та інші технологічні гіганти. Конкуренція між ними вже давно вийшла за межі створення найпотужнішої мовної моделі й дедалі більше концентрується навколо побудови цілих екосистем продуктів та сервісів.

    Ще кілька років тому головним завданням OpenAI було переконати людей у можливостях генеративного штучного інтелекту. Сьогодні ж перед компанією стоїть інша мета — перетворити ці технології на стабільний бізнес із прогнозованими доходами. Для цього необхідно створювати продукти, за які готові регулярно платити не лише окремі користувачі, а й великі компанії.

    Саме корпоративний сегмент розглядається як ключове джерело майбутніх прибутків. Бізнес-клієнти потребують інструментів для автоматизації процесів, роботи з великими масивами даних, управління документацією та підвищення ефективності співробітників. Агенти штучного інтелекту, здатні виконувати комплексні завдання без участі людини, потенційно можуть стати одним із найдорожчих і найприбутковіших продуктів на ринку.

    Аналітики зазначають, що якщо OpenAI реалізує свої плани, це може стати найбільшою зміною в історії ChatGPT та одним із найважливіших етапів розвитку всієї індустрії штучного інтелекту. Фактично компанія прагне створити універсального цифрового помічника, який стане невід’ємною частиною повсякденного життя мільйонів людей та робочих процесів тисяч компаній. Якщо раніше користувачі зверталися до ChatGPT за відповідями на запитання, то в майбутньому вони можуть доручати йому виконання повноцінних завдань, залишаючи штучному інтелекту дедалі більше функцій.

    Таким чином OpenAI готує не просто оновлення свого найпопулярнішого продукту, а масштабну трансформацію всієї концепції взаємодії людини зі штучним інтелектом. І саме від успішності цієї стратегії може залежати не лише майбутнє компанії, а й подальший розвиток глобального ринку ШІ, який уже зараз оцінюється у сотні мільярдів доларів і продовжує зростати рекордними темпами.

  • «Тижневий обсяг ринку за три дні»: monobank влаштував iPhone-бум на 1,4 млрд грн

    «Тижневий обсяг ринку за три дні»: monobank влаштував iPhone-бум на 1,4 млрд грн

    Український ринок електроніки отримав одну з найгучніших подій року. За три дні платформа monomarket, яка працює на базі monobank, продала техніки Apple на понад 1,4 млрд грн. За оцінками учасників ринку, йдеться приблизно про 20 тисяч iPhone, що можна порівняти з тижневими продажами смартфонів Apple по всій Україні. Масштабна акція викликала ажіотаж серед покупців, але водночас поставила питання: чи вдалося monobank заробити на такому розпродажі, чи це була дорога маркетингова кампанія?

    Кампанія стартувала 29 травня після анонсу співзасновника monobank Олега Гороховського. У своєму Telegram-каналі він повідомив, що будь-яку техніку Apple на monomarket можна придбати у розстрочку до 20 платежів. Одночасно покупцям запропонували знижки на популярні моделі iPhone 15, iPhone 16 та нову лінійку iPhone 17. Розмір дисконту залежав від моделі та сягав від 3% до 16%.

    Пропозиція миттєво стала вірусною в соцмережах. Користувачів привабила не лише можливість придбати смартфон без переплат, а й сама тривалість розстрочки. Для українського ринку електроніки програма на 20 платежів є фактично безпрецедентною. Більшість великих ритейлерів пропонують розстрочку на 10–12 місяців, тоді як monomarket збільшив цей термін майже вдвічі.

    Уже через кілька днів Гороховський оприлюднив результати кампанії. За його словами, покупці оформили близько 47 тисяч замовлень на загальну суму понад 1,4 млрд грн. При цьому значну частину продажів сформували саме смартфони Apple. За оцінками учасників ринку, протягом акції було реалізовано близько 20 тисяч iPhone різних моделей.

    Такі показники стали справжньою несподіванкою навіть для представників галузі. Український ринок смартфонів Apple залишається одним із найбільших у сегменті преміальної техніки, однак реалізація десятків тисяч пристроїв за три дні є надзвичайно високим результатом навіть за мірками великих національних мереж.

    Експерти пояснюють успіх кампанії одразу кількома факторами. По-перше, monobank має одну з найбільших активних клієнтських баз серед українських фінансових сервісів. За останніми даними, кількість клієнтів банку перевищує 10 мільйонів користувачів. По-друге, сервісу вдалося поєднати дві найбільш привабливі для покупців умови — суттєву знижку та довгострокову розстрочку.

    Водночас фінансисти звертають увагу, що така акція могла виявитися не надто прибутковою для самого банку. Річ у тім, що програма «Покупка частинами» передбачає фінансування клієнтів за рахунок банку, а отже monobank фактично кредитує покупців на тривалий період. При високій вартості смартфонів Apple це означає значні витрати на фінансування угод.

    За оцінками ринкових аналітиків, собівартість залучення коштів та обслуговування розстрочки на десятки тисяч дорогих пристроїв могла коштувати банку десятки мільйонів гривень. Додатковим фактором стали знижки, які також зменшували потенційну маржу продажів.

    Втім, для monobank прямий прибуток міг бути не головною метою. Експерти припускають, що кампанія виконувала одразу кілька стратегічних завдань. По-перше, банк отримав величезний інформаційний ефект. Протягом кількох днів акція залишалася однією з найобговорюваніших тем у соцмережах та профільних медіа. По-друге, monomarket отримав тисячі нових клієнтів, які раніше не користувалися маркетплейсом банку.

    Крім того, продаж техніки через власну платформу дозволяє monobank розвивати екосистему додаткових сервісів. Останніми роками банк активно виходить за межі традиційного фінансового сектору та пропонує користувачам страхові продукти, сервіси бронювання, інвестиційні інструменти та маркетплейс товарів.

    Аналітики також звертають увагу на загальну ситуацію на ринку електроніки. Попри війну та складну економічну ситуацію, попит на продукцію Apple в Україні залишається стабільно високим. Смартфони американського виробника традиційно входять до числа найпопулярніших преміальних гаджетів серед українців. Особливо високий інтерес викликають нові моделі після виходу чергового покоління пристроїв.

    Для конкурентів monomarket акція стала серйозним викликом. Представники ринку визнають, що запропонувати аналогічні умови без значного фінансового навантаження буде складно навіть великим мережам електроніки. Саме тому багато експертів називають кампанію monobank не просто розпродажем, а масштабною маркетинговою операцією з посилення позицій на ринку.

    Попри вражаючі результати, акцію вирішили не продовжувати після завершення триденного періоду. За словами Гороховського, кампанія була задумана як обмежена за часом пропозиція. Такий підхід додатково стимулював попит, адже покупці розуміли, що вигідні умови можуть зникнути будь-якої миті.

    У підсумку monomarket встановив один із найяскравіших рекордів українського ринку електроніки останніх років. Продаж техніки Apple на 1,4 млрд грн за три дні продемонстрував не лише силу бренду Apple, а й ефективність поєднання фінансових сервісів із сучасною електронною комерцією. Навіть якщо кампанія не принесла банку значного прямого прибутку, вона стала потужним інструментом залучення клієнтів і зміцнення позицій monobank у боротьбі за українського споживача.

  • По всьому світу фіксують проблеми в роботі цифрових сервісів

    По всьому світу фіксують проблеми в роботі цифрових сервісів

    У роботі низки популярних цифрових сервісів по всьому світу зафіксовано масштабні перебої. Користувачі з різних країн повідомляють про проблеми з доступом до банківських застосунків, месенджерів, стримінгових платформ, хмарних сервісів та телекомунікаційних систем.

    Про це свідчать дані сервісу моніторингу Downdetector, який фіксує скарги користувачів на роботу онлайн-платформ у режимі реального часу.

    Згідно з повідомленнями користувачів, проблеми спостерігаються у роботі низки фінансових сервісів. Зокрема, скарги надходять на роботу Monobank, ПриватБанку та Ощадбанку. Частина клієнтів повідомляє про труднощі з входом до застосунків, проведенням платежів та отриманням інформації про рахунки.

    Крім банківського сектору, перебої торкнулися й телекомунікаційної сфери. Користувачі мобільних операторів “Київстар” та “Vodafone Україна” повідомляють про нестабільне з’єднання, проблеми з доступом до мобільного інтернету та окремих цифрових сервісів.

    Масштабні збої також фіксуються серед міжнародних технологічних платформ. Скарги надходять на роботу Google Cloud та Amazon Web Services — двох найбільших у світі постачальників хмарної інфраструктури. Саме ці платформи забезпечують функціонування великої кількості вебсайтів, мобільних застосунків та цифрових сервісів, тому перебої в їхній роботі можуть спричиняти ланцюговий ефект для багатьох інших систем.

    На тлі проблем із хмарною інфраструктурою користувачі також повідомляють про перебої в роботі YouTube, Netflix, Discord, Zoom, Reddit, соціальної мережі X та месенджера Viber. У багатьох випадках йдеться про труднощі з авторизацією, завантаженням контенту, обміном повідомленнями або підключенням до серверів.

    Проблеми зачепили й сервіси корпорації Microsoft. Користувачі повідомляють про нестабільну роботу Microsoft Azure — однієї з найбільших платформ хмарних обчислень у світі. Також надходять скарги щодо роботи супутникової системи Starlink.

    Масштабний збій вплинув і на ігрову індустрію. Про перебої повідомляють користувачі Steam, PlayStation Network та Roblox. Частина гравців скаржиться на неможливість підключитися до серверів, проблеми з авторизацією та роботою окремих онлайн-функцій.

    Не оминули труднощі й сферу штучного інтелекту. Повідомлення про перебої надходять від користувачів сервісів Claude та Cursor, які використовуються для роботи з генеративним штучним інтелектом та програмуванням.

    Наразі офіційні причини масштабних збоїв залишаються невідомими. Водночас експерти припускають, що джерело проблем може бути пов’язане з перебоями в роботі великих хмарних провайдерів або мережевої інфраструктури, від якої залежить значна кількість цифрових платформ по всьому світу.

    Компанії поступово аналізують ситуацію та працюють над відновленням стабільної роботи сервісів. Частина платформ уже повідомляє про поступове усунення проблем, однак користувачі продовжують фіксувати перебої в роботі окремих ресурсів.

    Нагадаємо, подібні масштабні інциденти вже траплялися раніше. Зокрема, у квітні користувачі в різних країнах повідомляли про перебої в роботі популярних систем штучного інтелекту, серед яких Gemini, Claude, Copilot та ChatGPT. Тоді причиною також стали технічні проблеми в інфраструктурі, що забезпечує роботу цифрових платформ.